またもや数ヶ月クラスの更新頻度の当ブログではありますが、今回は久々にデジタル関連ネタ。ここ数ヶ月、こっそりと(しかもどっぷりと)ハマっていた「Personal AI Agent構築」について書きたいと思います。長くなっちゃったので2回に分けて。
AI課金の遍歴
個人で使うAIというと、チャッピーこと「ChatGPT」が代表的ですが、自分も最初は2年前(2024年)くらい?にChatGPTを使い出したのが走りでした。Plusプランに課金して、4oの会話能力に驚き、o1の分析能力に驚き、DeepResearchに驚き、と、ちょっとアホなチャットレベルだったものがどんどん進化していく祭りに参加する気持ちで月3000円を払っていました。昨年(2025年)、今でいうところのフロンティアAI各社が競争力のあるAIモデルを出し始め、それに合わせて自分もGoogle AI Plusに課金(2ヶ月間の半額割引で)、SuperGrokのトライアル(3日間くらい)、Claude Proプランに課金(3ヶ月間の半額割引で)、そしてCursor Proプランに課金と、ここ数年で見事なまでに乗り継いできました。それぞれ特色があって、得手不得手も分かって面白かったですね。この段階でもコーディングなどはだいぶ進化していましたが、一方でわれわれ一般庶民が使いがちな「○○駅から○○駅の間で評判のラーメン屋を教えて」みたいな質問をすると、盛大なハルシネーションで架空の店舗を出したり、有名チェーン店だけどその駅周辺には無い、とかの結果を出してきたり、特にGeminiがそうでしたが、(Googleなのに)Web検索を積極的にやらずハルシネーションの傾向が強かった印象です。
その中で感じたのは、Claudeは確かに賢い、ということ。自分で出した結論に対し自分でWeb検索などを使い検証して精度を上げたり、ClaudeCodeでPC環境の問題解決できたりと、当時「こいつスゲー」と感心していました。ただ、賢い一方で、「トークン消費」を気にしながら使うのがスタンダードになってしまったんですよね。今ではトークンの利用量が見えるのがどのAIサービスでも一般的になってきていますが、当時はClaudeだけが5時間枠と1週間枠のトークン使用量ゲージがあって、使えば使うほど残量が減っていく。特に何かアプリ的なものを作らせようとするとガリガリトークン使用量を食ってしまうので、「こういうのを試したいけど、もったいないからやめておくか…」と一瞬考えてしまう。AIを使っているのに、AIを使うことへの精神コストが一番高い状態になっていました。で、月額課金してるのに、ケチケチ使って、結局それほど消費していないという状況になっていっておりました。
そんな折にCursorを試し始めたところ、驚いたことにClaudeのモデルでなくてもデフォルトで使えるComposer 2.5というLLMモデルが十分優秀で、しかもトークン使用量が全然減らない。賢さにそれほど差がないなら、課金の掛け捨て感覚も変わってきます。同じ頃、これまでOneNote等で書きためていたノート環境をNotionへ移行しており、AIもNotion AIで一本化しようかとも考えたのですが、同じくメモアプリとして話題のObsidian+Cursorの組み合わせで、個人がメモアプリとして使うにはとっつきにくいローカルのMarkdownファイルが、そのままAIの作業領域になることを理解。ここから風向きが変わって、Notion全振りはやめて、ノートについてはObsidianに全移行することになりました。(Notionは年間契約だったので、更新せず終了予定)
Cursorはもともとコーディング補助ツールとして発展したものですが、ClaudeCodeの登場以降、よりエージェント寄りの機能が強化されていきました。ただ、やはりベースはコーディングツール。自分は特にそれほど作りたいアプリがあるわけではなかったので、いざ画面を前にしてもやりたいことが浮かばずそこで止まってしまう。ここで、自分がやりたいのは「コーディング」じゃなくて、「エージェント」を持ちたいのでは?、という想いが強くなりました。この当時はCursorのモバイルアプリが無く、iPhoneから使えなかったのも大きかったかな。(その後モバイルアプリ出ましたね)
Hermes Agentとの出会い
調べていく中で出会ったのが、Xでのtoraさんのこの投稿でした。
AIエージェントって便利そうだなと思ったことはありますか?…僕は北海道で使っていたのですが、新潟に移住した関係でPCをまだ設置できていません。いまの環境でもエージェントを使いたい。そう考えて、前から興味のあったサーバーを借りてiPhone(正確にはiPad)だけで完結する構成を構築しました。
(Hetzner サーバー $6/月、ChatGPT Pro、Hermes Agent(無料)、Notion、Telegram)
※2026-06-21の投稿
「家にPCがなくても、月6ドルのVPSがあれば世界中のどこからでもエージェントを働かせられる」。これを見た瞬間に「やりたいのはこれかも」となりました。しかも土台のHermes Agent自体はオープンソースで無料。Cursorユーザーとしては「サーバー借りて、AIエージェントをセットアップする」ということに取り組むのが楽しそうに聞こえ、ワクワクしたのを覚えています。
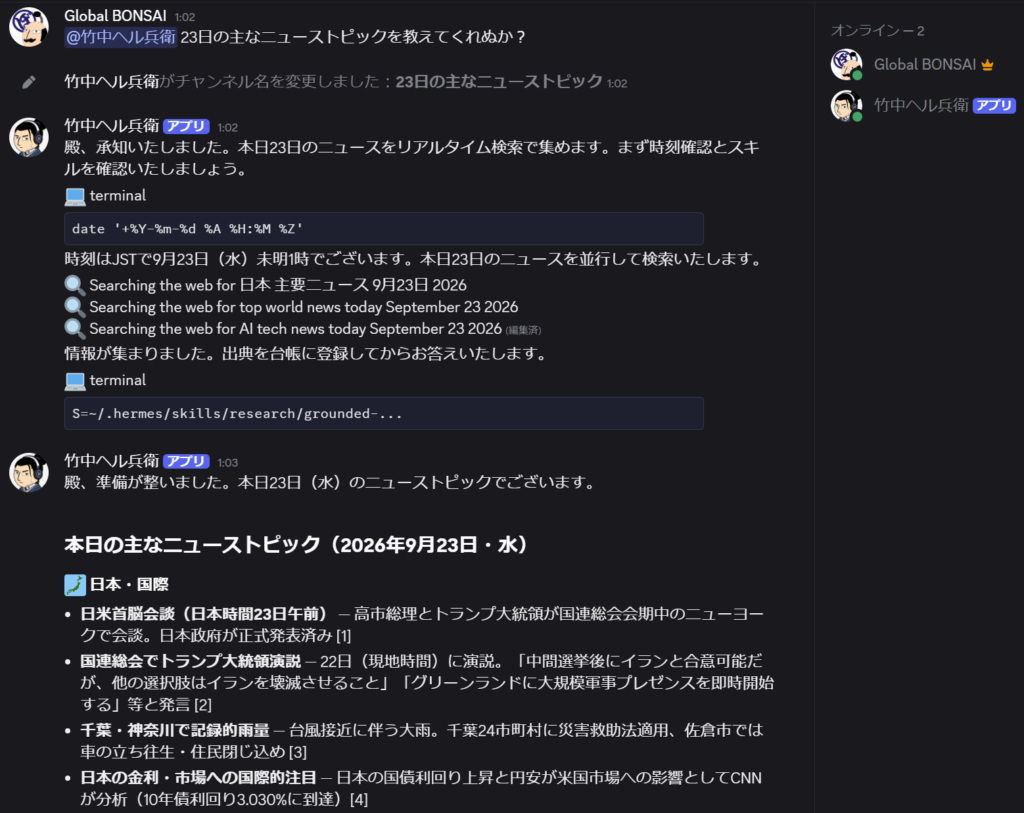
で、実際にHetznerのVPS(仮想サーバ)を契約して構築を始めたわけですが、これが予想以上にトントン拍子に進む。サーバー選定やファイアウォール設定、Discord接続まわりを、全部Cursorに依頼して構築していったのですが、対話で指示しながら進めれば、こっちが本格的なLinuxの知識を持っていなくてもどんどん形になっていくし、何かエラーが出たらそれを貼り付けて解決策を聞きまた対処する。「AIエージェントの構築をAIに聞く」構築そのものが楽しくなってしまい、時間を忘れて夢中になっていました。
この構築を通じて、AIの「ハーネス」(エージェントの土台部分)とLLM(頭脳)の関係が腹落ちしていったのも大きな収穫でした。そしてHermes Agentはこのハーネスとしての出来が抜群で、記憶まわりの機能が優秀なんですよね。具体的には3種類あって、SOUL.mdはエージェントの人格と口調を定義するファイル。「竹中ヘル兵衛」という名前で、ユーザーを「殿」、自分を「拙者」と呼ぶ家臣キャラは、ここに私が意図して書いたものです(正確には、その人格設定もAIに書かせたのですが)。USER.mdは私という人間のプロファイルで、氏名や環境、日本語で回答してほしいこと、登山とバイクツーリングが好きだという情報が、やりとりの中から必要な部分だけが抽出されて勝手に蓄積されていきます。「この人、山とバイクが好きなんだな」と私が説明した覚えはほぼないのに、いつのまにか反映されてる。そしてMEMORY.mdには、エージェント側が運用の中で学んだ技術的な教訓が溜まっていきます。「この設定はこうやると壊れる」「この手順はこれが正解」といった、いわば家臣が仕事を通じて書き溜めた自分用の業務日誌ですね。手順が固まった作業はさらにスキル化してくれるので、二回目からは「例のやつやって」と言えば通ります。まさに自分専用のAI家臣のできあがりです。
安いLLMで構築したら、セキュリティの穴だらけだった
LLMの選定には、OpenCode Go(初月5ドル)を使って、安くて評判の中国製LLMを中心にお試ししまくりました。DeepSeek V4 Flash(旧版)の安さと速さには驚かされましたし、Kimi K2.7 CodeやGLM 5.2の賢さも本物で、その中間でコスパ・バランスの良かったMiniMax M3をしばらく中心に使っていました。
しかし、構築をDeepSeek V4 Flashなどの安いモデルたちに任せていろいろ作っていくうちに、問題に行き当たります。Cursorに検証をさせると、構築された環境にセキュリティの穴が散見されたんです。開ける必要のないポート、緩い権限設定、ハードコードされたクレデンシャル…。一つ一つは軽微でも、積み重なると「このサーバー、外からどうなってるんだっけ」と不安になるレベル。賢くて安いモデルは「動くもの」は作れるんですが、設計として堅牢なものを作り切るには、やはり知能の高いモデルを使わざるを得ない、というのが実感でした。
というわけで、仕方なく当時一番賢かったGLM 5.2を環境構築のメインに起用しました。こいつは中国の智譜AI(Zhipu AI)というところが出しているLLMモデルですが、当時「Claude Opus 4.7を超える性能」と言う触れ込みで、若干誇張気味かなと思わなくも無いですが、ちゃんとセキュリティ検証して実装できるくらいには賢いモデルでした。チャットのやりとりの最後の方で急に中国語になっちゃったりするのはご愛敬でしたが(笑)。ただ、このGLM5.2はClaudeほどでは無いものの、DeepSeek等と比べるとコストがややかかるモデルで、月間10ドルのOpenCode Goプランでは月間トークンがみるみる減ってしまい、あっという間に使い切ってしまいました。
そこで慌ててOllama Cloud Pro(20ドル)を契約して、構築の続きをできるようにはしたのですが、それでも頭の片隅に引っかかっているものがありました。どうしても「手元に計算資源」を確保しておきたい、という想いです。
手元に計算資源が欲しい理由
後押ししたのが、当時の時事の流れでした。6月には米政府の国家安全保障当局の指示によりAnthropicのFable 5の提供が突如停止され(約2週間後に提供再開が発表されましたが)、7月には中国当局が自国の最先端AIモデルへの海外からのアクセス制限を検討しているという報道がロイターから流れました。賛否はともかく、AIの利用は国家間の対立によって制限されうる——そう感じさせられる出来事が続いたんです。クラウドの課金プランは、契約が続く限りコスパは良く素晴らしいんですが、「明日使えなくなるかもしれない」というリスクがあるとなると、この楽しいAIフィーバー体験を強制終了されてしまうかもしれない。
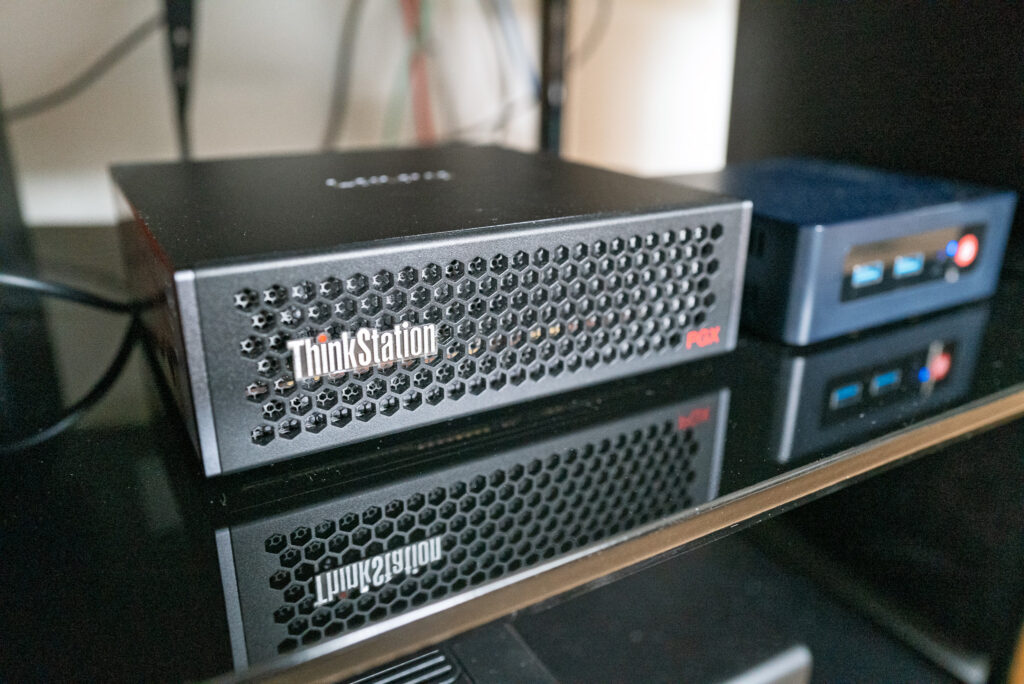
そんな折、8月に入って、自宅でローカルLLM環境を構築できるレベルのGPU(GB10)を積んでいるDGX Sparkおよびその互換機の需要が高まり、どんどん値上がりし始めました。今年春ごろに一度なんとなく見た際は70万円程度が相場だった記憶があるのですが、これが90万円~100万円台の値付けになっているし、在庫もあったりなかったり。「ちょっと遅かったかな」と思いましたが、たまたま見たサイトでLenovoのThinkStation PGXが86万円で販売され、在庫があるのを発見。少し迷った末に下した決断の根拠がこちら。
「バイク1台増車するより安い」
完璧な理論でした。即購入です。一般民にもバイク乗りにも通じなさそうな理論ですが、分かる人には通じるはず。(通じないか)
Qwen3.8が世界をひっくり返した
ローカルLLMの実力はいちおう事前に予習はしておりました。まずQwen3.5 35B A3BやGemma4 26B A4Bを載せてみたのですが、応答速度はそこそこ速いものの、その受け答えがもう、あれです、一昔前にChatGPTが盛大にハルシネーション(もっともらしい嘘)を出していた頃とそっくりな質感。「やはりローカルLLMはこんなもんか。簡単なスキル発動は任せられるけど、詳細な調べ物やコーディングはさすがに質的に無理だな」というのが、正直な感想でした。86万円分の期待感はどうなることかと…。
ところが、その3日後(8月14日)にQwen3.8 27Bが登場して、この概念が根っこからひっくり返りました。決定的だったのが、10月に計画していた南アルプスの山行計画をレビューさせた時です。もともとこの計画、それまでのローカルLLMモデルに試しに調査させて作らせたものなのですが、後から検証してみると行程上存在しない山の名前が挙がっていたり、標高やコースタイムが実際と全く違っていたりと、計画そのものが破綻していました。それを試しにQwen3.8 27Bにレビューさせたところ、山の名前・標高・コースタイムを全部検証した上で修正したばかりか、こちらも認識していなかった帰りのバスの時刻表まで調べて、「下山に1泊を加えないとこの計画はそもそも破綻する」と指摘してきたんです。この時、「ローカルLLMのサイズで高度な推論は無理」という概念が吹き飛びました。それくらい驚いた出来事でした。
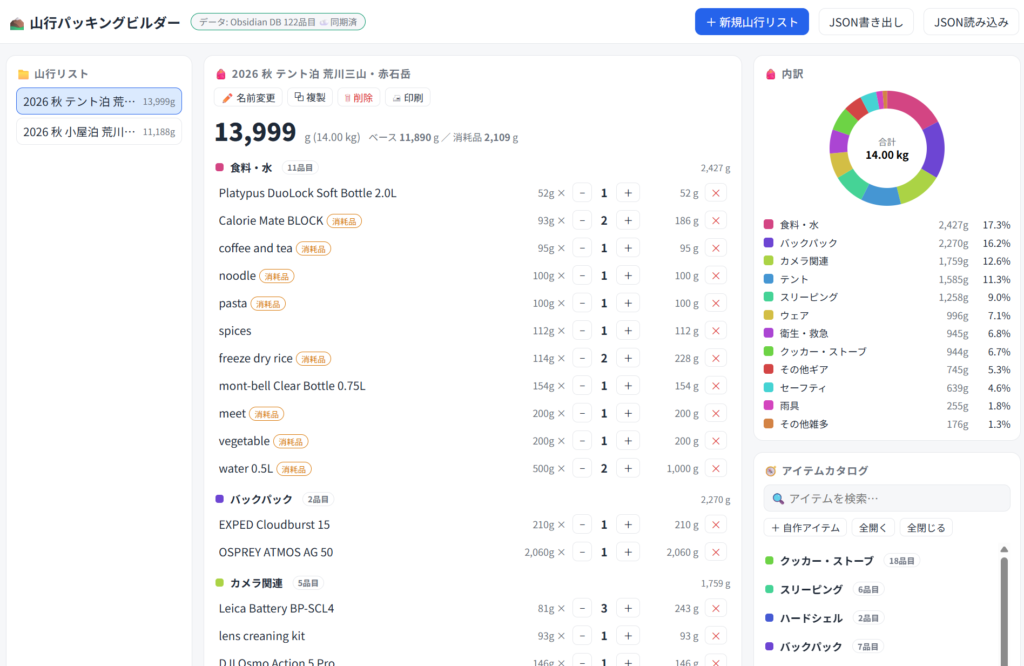
ただ、Qwen3.8 27Bには一つだけ難がありました。その深い推論のため、とてつもなく長考型なので、例えば何かを作ってもらう指示をして、20~30分後に「できました。設計が。次に実装しますか?」みたいな感じになる。なので普段使いにはちょっと使いにくいんですよね。賢いんだけど、考える。ずっと考える。その間、私が待っている。なので、一旦Ornith 1.5というレスポンスの速い別モデルに切り替えた時期もあったのですが、その後登場したQwen3.8 Flash Nextが、まさにその中間の抜け穴を埋める存在でして。ほどほどの推論の長さで、精度もしっかり。登山のパッキングリストを管理するビルダーを依頼したら、一発でちゃんと動くものを作りきった。これが今、DGX Spark1台で動かせるローカルLLMの実質スタンダードになっていると私は思っています。
今の体制
ということで、現在の体制はこうです。
- クラウド側:Ollama Cloud ProのGLM 5.3 Flash。がっつりトークンを使って作業させる担当
- ローカル側:ThinkStation PGX上のQwen3.8 Flash Next。トークンの概念が存在しない世界
この二本立てにしてから、「トークンがもったいないから聞くのやめとこ」という思考が消えました。Claudeを利用していた時に感じていた「AIを使うことへの精神コストが一番高い状態」は、これで完全に解消です。今のコストはVPS月6€弱、Ollama Cloud Pro 20ドル、そしてバイク1台分(?)のワークステーション。Ollama Cloudは一応米国でホストされ入力データやプロンプトが中国に流れることは無いし、自分の環境では遅延が少なくレスポンスが速い。オープンウェイトのLLMモデルとしてこの記事を書いている2026年9月23日時点では、Z.aiのGLM5.3-Flash、Qwen.AI(Alibaba)のQwen3.8 Flash Next、DeepSeekのDeepSeek V4.1 Flashが、画像も読めるし、速さと安さと賢さのバランスでガシガシ使える3強かなと思います。
86万円、元は取れない。それでも買ってよかった
ThinkStation PGXの購入費86万円。正直に言うと、これを「トークン代の節約や生成AI契約の削減で元が取れる」なんて思ってはいません。電気代と突き合わせたら、そう簡単に元は取れない計算になります。
それでも価値があると思っているのは、別の理由です。自分で構築していく過程で、Claude CodeやCodexをただ使っていたら意識できなかったであろう知識が、一気に身についたんですよね。ハーネスとLLMの関係性、vLLMやSGLang等の推論エンジンの役割、LLMのパラメータ数とは何か、MoE(Mixture of Experts)技術、量子化技術、そして、これらの技術がそれぞれ「賢さ」「速さ」「必要なメモリサイズ」にどう影響するのか。体感で理解できるようになった。例えば「なぜこのモデルはこのGPUサイズで動くのか」「なぜこのモデルは速いのに賢くないのか」が、モデル名を見て構造から推測できる。この知識が身につくだけでも、86万円の価値はあると感じています。
PGXを購入してからまだ1ヶ月ちょっとですが、やることがいっぱいあって全然追いつかないし、業界の知識のアップデートも週単位どころか日単位で進んでいく。こんな時代はなかなかありません。つい最近もTypeSafe AIのJevというのが話題になったのですが、これも企業の業務に組み込むユースケースでは画期的な技術になりそうだし、個人ユースでも工夫次第でリアルタイムの処理など面白いことができそうです。単純なスケーリング則だけでは無い、まだまだ新しいブレイクスルーが出てくるのだろうなと思うと、本当に面白いですよね。
いい加減長くなってしまったので、続きは別投稿で。